DDR6 内存条短了 44%,带宽却翻了倍:CPU 真能直接跑 AI 了吗
11 月 18 日,JEDEC 固态技术协会放出了 DDR6 DRAM 的规范预览版。这条消息在技术圈里传开时,最常见的两个标题是「内存条缩短 44%」和「带宽是 DDR5 的四倍」。两个数字都对,但指向的不是同一件事;而把它直接读成「以后不用显卡了」,则是把三条不同的技术路线揉成了一条。
先把文件本身说清楚。JEDEC 在声明里反复强调:这次公布的是开发中的计划,不是定稿标准,审批过程中仍可能变动,理事会也可以不予批准。模组长度、速率、总线宽度这些数字是方向,不是已经能下单的规格。DDR5 的第一份规范在 2020 年公布,起步速率 4800 MT/s;DDR6 距它整整六年。
一、DDR6 到底改了什么
最直观的是尺寸。一条标准 DDR5 内存条约 133 毫米,DDR6 的目标长度是 74 毫米,短了约 44%,只比笔记本用的 SO-DIMM 长一点点。变短不是审美选择,而是为了让同一块主板塞进更多内存插槽、容纳更高的系统密度——JEDEC 明确说这是为高容量模组做的优化。
真正决定性能的是三处改动。第一,速率:DDR6 RDIMM(服务器常用的注册内存条)从 12.8 GT/s 起步,也就是 12800 MT/s,路线图指向 14400 MT/s 及更高;对照值是 DDR5 RDIMM 的 9.2 GT/s。第二,总线:从 64 位加宽到 96 位,提升 50%。第三,结构:子通道从 DDR5 的两个 32 位改成四个 24 位,Bank 数量翻倍,并改进刷新机制。这三样叠在一起,官方口径是产品上市时带宽提升「超过 50%」。
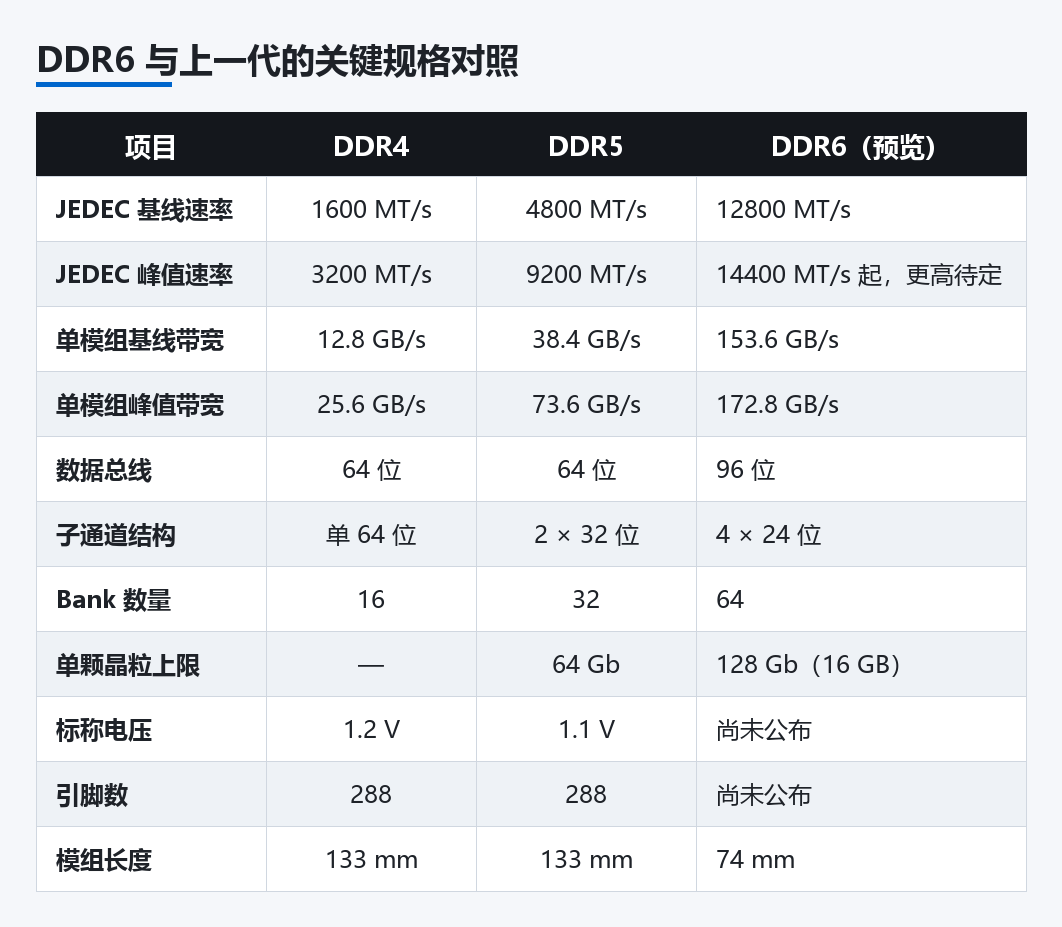
那「四倍」从哪来?Tom's Hardware 的算法是拿 DDR6 的基线 153.6 GB/s 对 DDR5 的基线 38.4 GB/s(4800 MT/s)——这是标准起步值对标准起步值,刚好四倍。JEDEC 的 50% 是拿 DDR6 起步值对当前 DDR5 RDIMM 的 9.2 GT/s(每条约 73.6 GB/s),属于现实产品对现实产品。两种说法都没错,差的只是参照物。JEDEC 还特意加了一句:带宽目标不等于应用性能有同样幅度的提升。
容量是另一个被低估的变化。DDR6 支持单颗 128 Gb(16 GB)的 DRAM 晶粒,是早期 DDR5 模组密度的四倍,并可通过硅通孔堆叠封装。美光此前给出的路线图提到 1 TB 服务器模组——当然那是潜在配置,不是 JEDEC 承诺的每系统标配。电压、引脚数、最终形态(RDIMM、UDIMM 还是 CAMM)都还没定,行业普遍预期首批商用模组在 2028 到 2029 年。
二、「DDR6 和 DRAM 对比」是个伪命题
这里必须厘清一个常见混淆:DDR6 本身就是 DRAM。DDR 是双倍数据率同步动态随机存取存储器的缩写,DDR4、DDR5、DDR6 是它的代际;LPDDR6 是低功耗移动版本;而 HBM、GDDR 同样属于 DRAM 家族,只是为不同目标做了架构改造。把它们并列比较,就像拿「第六代汽油发动机」和「发动机」对比。
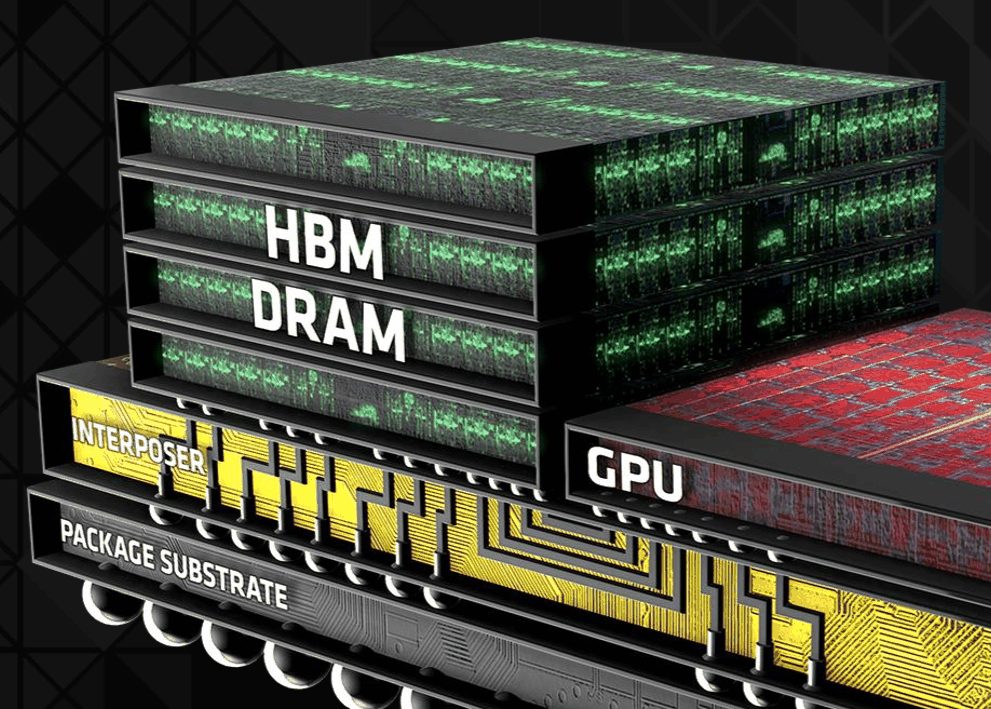
真正值得比的是三种分工:标准 DDR 插在主板上、容量大、可更换、成本低;GDDR 焊在显卡上、追求高带宽;HBM 用硅通孔把多层晶粒竖起来堆叠,通过中介层紧贴 GPU 或加速器,用极宽的接口换取极高带宽。JEDEC 这次把 AI 推理和智能体 AI 写进 DDR6 的设计目标,指向的是第一条路线能吃到多大的 AI 蛋糕。
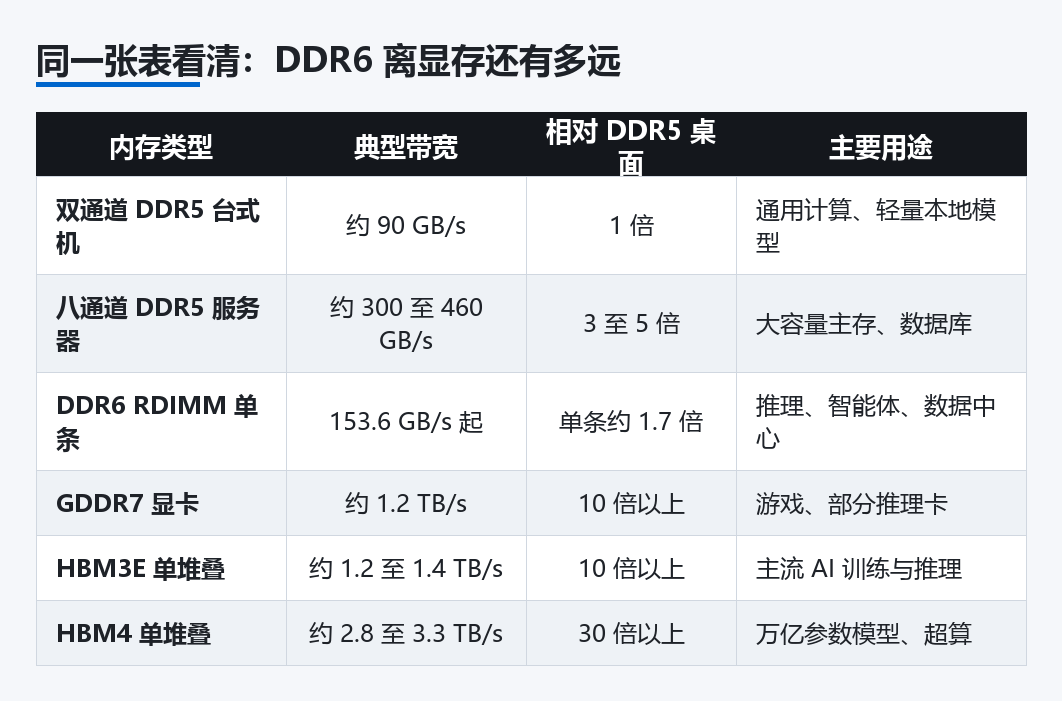
差距依然是数量级的。双通道 DDR5 台式机大约 90 GB/s;八通道 DDR5 服务器 300 至 460 GB/s;DDR6 单条起步 153.6 GB/s;而 GDDR7 约 1.2 TB/s,HBM3E 单堆叠 1.2 至 1.4 TB/s,HBM4 单堆叠 2.8 至 3.3 TB/s。DDR6 把标准内存的天花板抬高了,但离显存还有一个数量级。
三、它能替显存吗:能替一部分,但不是同一种活
先说结论:DDR6 进入数据中心,靠的不是取代 HBM,而是接住 HBM 装不下的那部分。推理服务里,模型权重和 KV 缓存的容量需求涨得比带宽还快。一张 H200 有 141 GB HBM,装下大模型后留给 KV 缓存的空间并不多,而并发用户数直接决定每词元成本。于是产业界开始搭分级存储:把最热的权重和解码阶段放在 HBM 或片上 SRAM,把冷权重、长上下文的 KV 缓存往下沉到 DDR5、CXL 内存池,甚至更便宜的介质。
这正是 JEDEC 在声明里点名 AI 推理和智能体的原因——这些负载需要「靠近 CPU 的大容量和性能」。DDR6 的单条 153.6 GB/s、单颗 16 GB 晶粒和 74 毫米短条,本质上是在给这一层扩容。它替的是「显存不够用」里的容量缺口,不是「算力等数据」里的带宽缺口。
反过来看,英伟达自己的产品路线也印证了这种分层。面向预填充阶段的 Rubin CPX 用 128 GB 的 GDDR7 而不是 HBM,因为预填充是计算密集型,对带宽没那么敏感,GDDR7 每字节成本约为 HBM 的五分之一。这说明厂商的思路早已不是「所有数据都塞进最贵的内存」,而是按阶段匹配最便宜的那一层。
四、CPU 加 DDR6 直接跑 AI:可以,但线画在带宽上
这是最值得单独回答的问题。纯 CPU 跑大模型的技术门槛其实很低,llama.cpp 之类的工具早已支持;真正的门槛是一条除法:
每秒词元数 ≈ 内存带宽 ÷ 模型权重字节数。
生成每一个词元,都要把模型的权重从头读一遍。权重 4 GB、带宽 90 GB/s,理论上限就是每秒 22 个词元;权重 41 GB、带宽还是 90 GB/s,就只剩每秒 2.2 个——一句话要等一分多钟。这也解释了为什么加核心数收效甚微:线程 4 条、8 条、16 条时速度还能爬一点,到 32 条就走平,因为核心在等内存,不是在算。
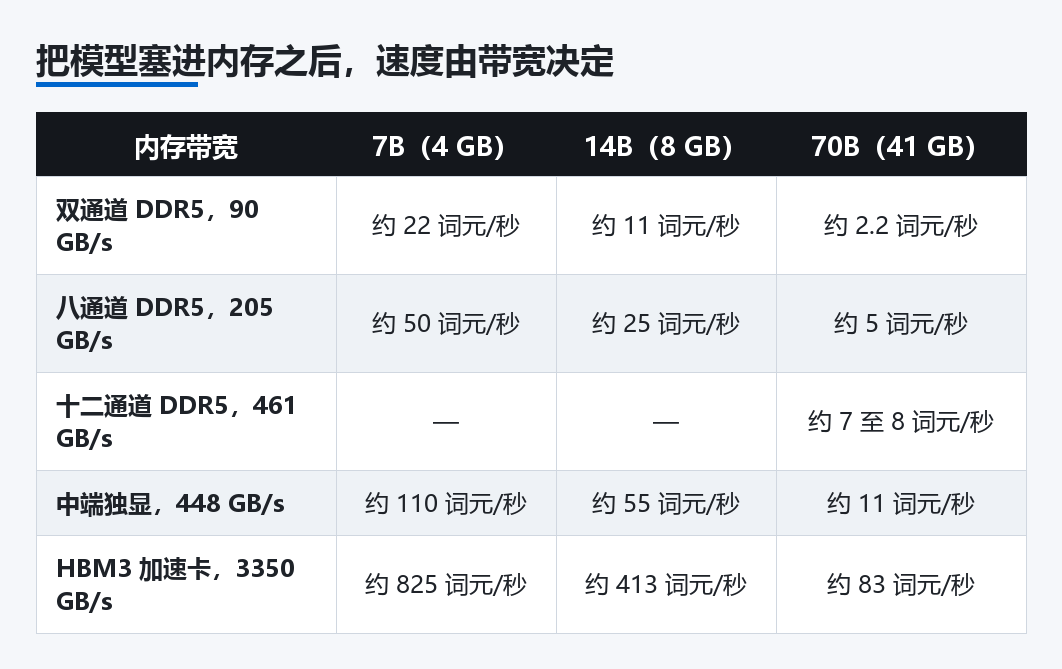
把 DDR6 代进去算一遍:单条 153.6 GB/s 大约是双通道 DDR5 的 1.7 倍;如果服务器做到八通道甚至十二通道,总带宽会进入 TB/s 量级,70B 模型(Q4 量化约 41 GB)的理论上限可以从每秒 5 到 8 个词元提升到每秒 20 到 30 个。这个区间已经接近人的阅读速度,做离线批处理、内部工具、对延迟不敏感的智能体任务完全够用。但请注意两个前提:一是这组乘法建立在通道数堆满的假设上,消费级平台短期内做不到;二是实际吞吐通常只有理论值的 60% 到 80%。
更现实的路径是混合专家模型。这类模型总参数很大,但每个词元只激活其中一小部分——带宽公式里的分母从「总权重」变成「激活权重」。此前有玩家用停产的傲腾持久内存、40 核至强、不插显卡,把 2.8 万亿参数的 Kimi K3 跑了起来,靠的就是混合专家加超大容量;代价是每秒 0.85 到 1.5 个词元。DDR6 若能同时提供大容量和更高带宽,这类方案会从「行为艺术」变得稍微实用一些,但依然不是高并发在线服务的对手。
五、所以答案是
未来会出现「CPU 加 DDR6 内存直接跑 AI 服务」吗?在特定场景里,会。小模型、MoE 模型、离线任务、本地隐私推理、把冷数据留在 CPU 侧的分级架构,都是 DDR6 的主场;JEDEC 把智能体 AI 写进设计目标,正是押注这条路。但在需要高并发、低延迟的在线推理上,HBM 的 TB/s 级带宽短期内没有替代方案——算力每两年增长约三倍,HBM 带宽同期增长不到两倍,这道「内存墙」还在变宽。
换句话说,DDR6 让 CPU 从「装得下模型」向「勉强用得上模型」挪了一大步,但「跑 AI 服务」这几个字里,还藏着并发、延迟、成本三笔账。标准预览版只是第一步:标准尚未定稿,模组还没流片,首批商用产品要到 2028 年前后。真要等 DDR6 装机,还得再耐心几年。
当前文章标题:DDR6 内存条短了 44%,带宽却翻了倍:CPU 真能直接跑 AI 了吗
当前文章地址:https://www.2109.top/4625/
来源:2109博客 地址:https://2109.top 文章版权归作者所有,未经允许请勿转载。
转载及其他合作需求请微信联系博主
