1B 模型登顶机器人「全球统考」:一文读懂 Meta-World MT50 榜单与 50 项任务
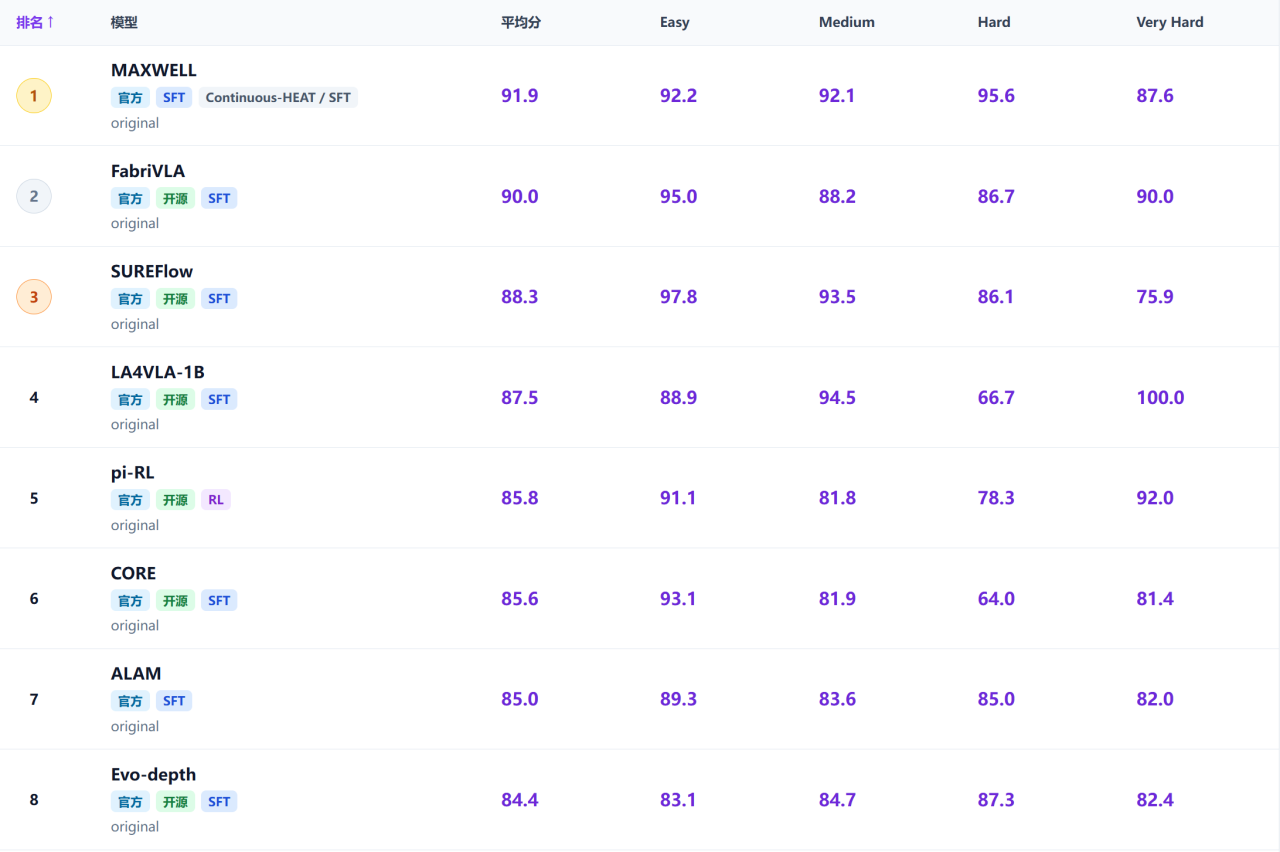
最近机器人圈出了一条让不少人意外的消息:中国科学院工业人工智能研究所自研的 Maxwell 具身智能大模型,登上了国际主流机器人操作仿真评测基准 Meta-World 的 MT50 最新榜单第一——四档难度平均成功率 91.9%,总体成功率 92.2%,高难度档(Hard)成功率 95.67%。中国科学院工业人工智能研究所近日发布这一消息后,大家问得最多的两个问题是:Meta-World 是一场什么考试?这 50 项任务又是怎么考的?这篇文章就把这份机器人操作的「全球统考」讲清楚。
Meta-World:机器人操作的「模拟考」
Meta-World 是加州大学伯克利分校团队在 2020 年提出的机器人操作仿真评测基准。它把抓取、搬运、开门、抽屉这些机器人最日常的操作任务搬进物理仿真环境,让不同模型在完全相同的规则下反复「考试」,再用统一的成功率指标排出高下。打个比方,它在具身智能领域的地位,有点像 NLP 界的 GLUE、视觉界的 ImageNet——给全行业一把统一的尺子,谁的模型更强,跑一遍便知。围绕它形成的 Evo-SOTA 等公开榜单,收录了 Physical Intelligence、Google DeepMind、阿里巴巴、美团、卡内基梅隆大学(CMU)、麻省理工学院(MIT)、剑桥大学、丰田研究所等机构的模型成绩,是机器人操作方向引用最多的「成绩单」之一。
Meta-World 备有好几套「考卷」:最简单的是 ML1 单任务卷,进阶是 MT10 十项任务卷,而 MT50 就是那份最难的综合卷——50 项任务一次全考,每项任务按不同难度分别测试,本次总计 2500 条轨迹。更「狠」的是难度设计:每项任务都要在 Easy、Medium、Hard、Very Hard 四档难度下各考一遍,物体位置、抽屉开合角度、门锁状态等条件逐档随机化。想靠背题拿高分是不可能的,模型只能拼真正的泛化能力。
50 项任务,到底考什么
MT50 的 50 项任务,覆盖了机器人操作的大部分基础动作。按操作对象大致归类,可以分成十大类:从开关抽屉、柜门这类「入门级」任务,到用锤子敲钉、用长杆够取远处物体这类「工具使用」任务,再到插销装配这种毫米级对位的精细活,以及投篮、踢球这种动态目标——一张卷子,把机器人「手上的活」考了个遍。
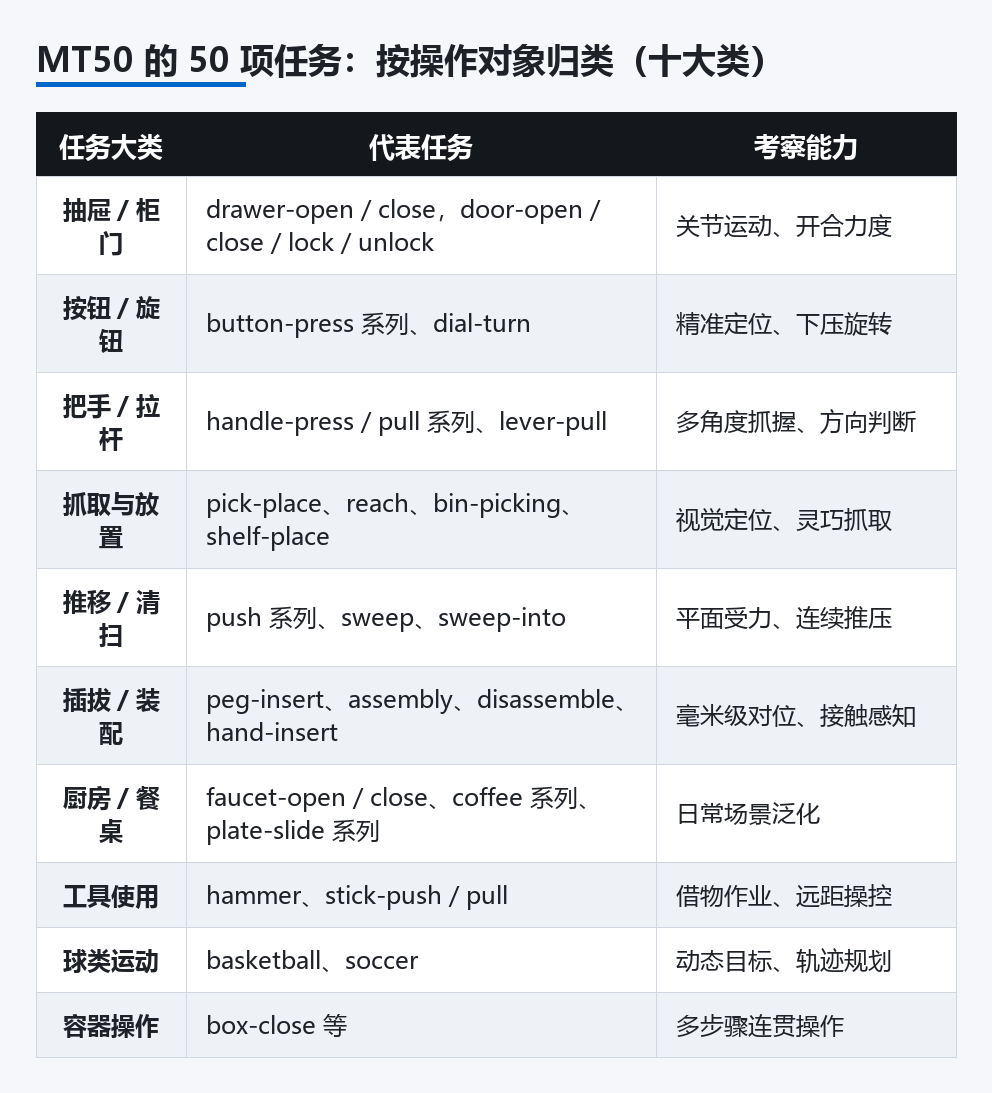
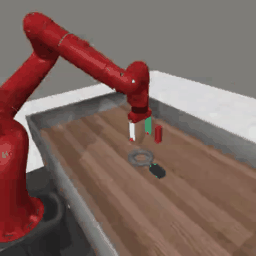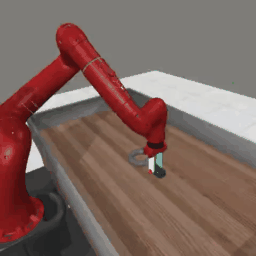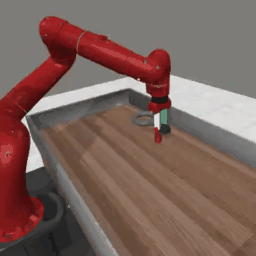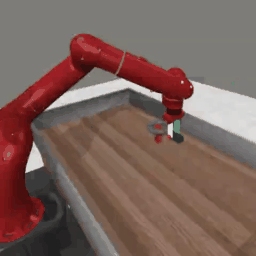
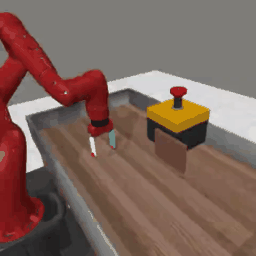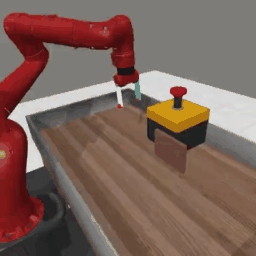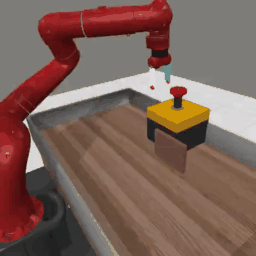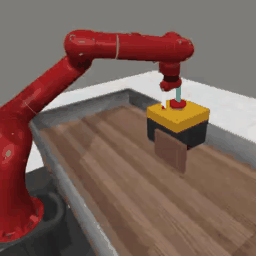
这些任务看着简单,实际每一条都在考验「感知—规划—执行」的全链路:模型要识别物体与目标的空间关系,连续执行接近、抓取、移动等动作,还要根据接触状态实时调整手法。螺母要拧上柱、球要投进筐、按钮要绕过障碍物按下去——任何一环差之毫厘,整条轨迹就判失败。下面是 Maxwell 的两段仿真演示:螺母套柱,以及绕障按按钮。
Maxwell 的成绩单
再来看这次的榜首成绩。本次评测覆盖 MT50 全部 50 项任务、共 2500 条轨迹,Maxwell 成功完成 2305 条,总体成功率 92.2%;四档难度平均成功率 91.9%,比榜单第二名(约 90.0%)高出近 2 个百分点;Hard 高难度档 300 条轨迹完成 287 条,成功率 95.67%,打破该榜单纪录。
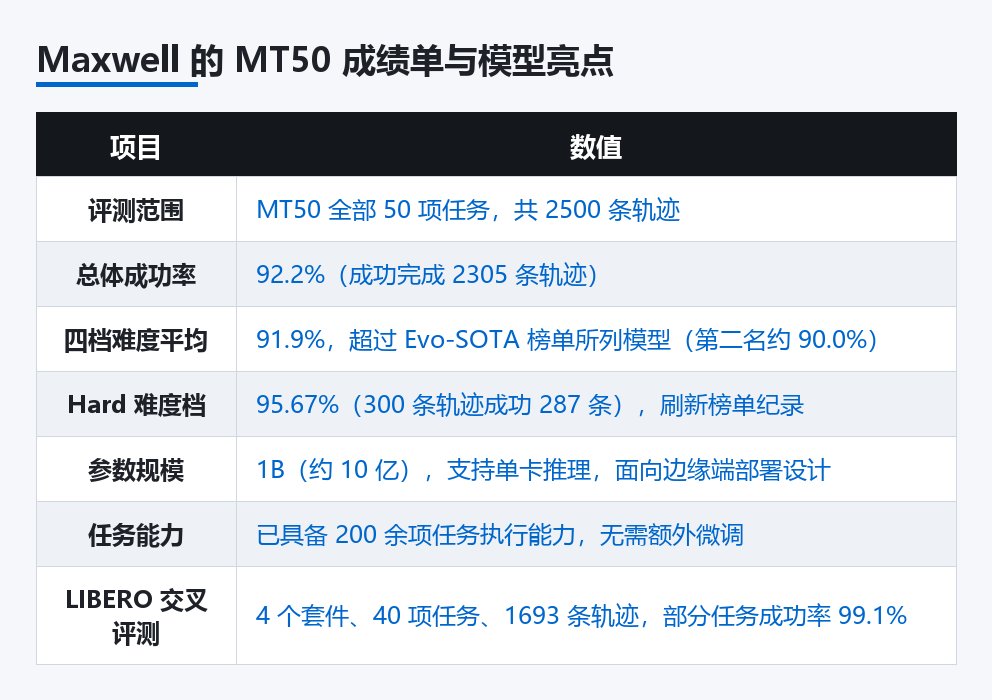
更值得注意的是它的「体型」:Maxwell 只有 1B(约 10 亿)参数,支持单卡推理,从设计之初就面向边缘端部署。在动辄几十亿、上百亿参数的具身大模型竞赛里,这个小个子选择以小博大——目前已具备执行 200 余项任务的能力,且无需额外微调。团队还在 LIBERO 仿真环境做了交叉验证:40 项任务、1693 条轨迹,部分任务成功率达到 99.1%,演示包括开启炉灶放置水壶、把杯子放进微波炉等更贴近家庭场景的多步任务。
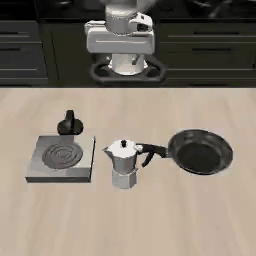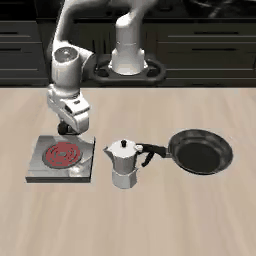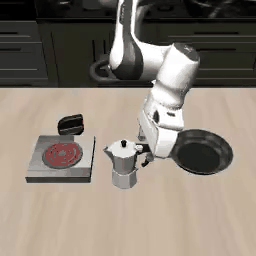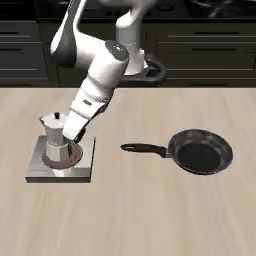
真机演示同样在线:机械臂抓起纸杯、移动、稳稳放到目标位置,一气呵成——仿真里练出的能力,正在向真机迁移。

同台竞技的都有谁
从公开榜单看,MT50 已经汇集了二十余个模型的评测成绩,背后是一份横跨产业界与学术界的大名单。从榜单前八名看,Maxwell 之外,开源模型 FabriVLA 以 90.0 分位居第二,SUREflow、LA4VLA-1B、pi-RL 等紧随其后。值得留意的是,第四名 LA4VLA-1B 同样只有 1B 参数,还在 Very Hard 难度档拿到了 100 分——小模型在特定难度上的爆发力,正在改写「参数越大越强」的直觉。
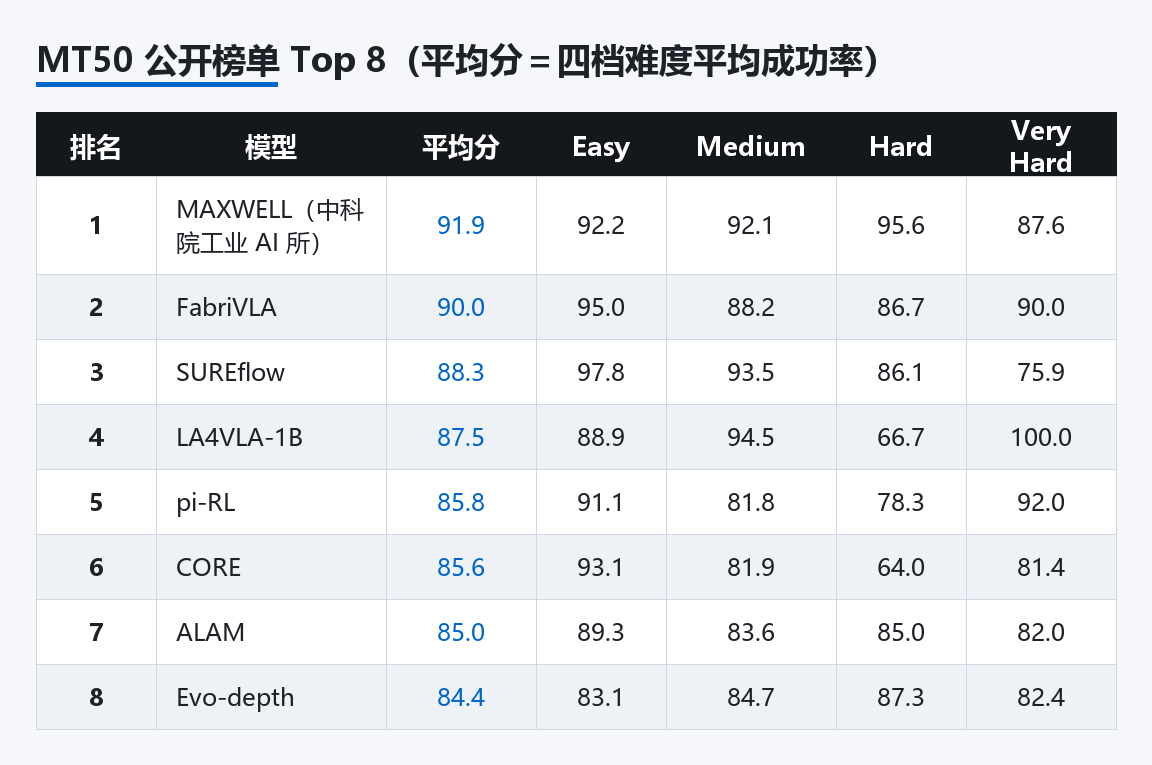
对国内读者来说,这次登顶还有另一层看点:在这样一份全球机构云集的成绩单上,第一名由中国团队收入囊中;而 1B 参数、单卡推理的工程化路线,也为具身智能的落地提供了另一种思路——机器人「大脑」的竞争,不只是算力的军备竞赛,轻量化同样是通往通用具身智能的路。
模拟考高分 ≠ 现实胜任
当然,也要给这份成绩单泼点冷水:MT50 是仿真环境里的考试,测的是「任务完成度」,而不是「物理适应度」。模型可能在固定摩擦系数、固定物体质量的标准测试集上拿高分,却对真实世界的物理参数扰动缺少覆盖。就在 9 月 26 日,国内团队发布的 RoboTwin-Phys 基准一口气新增了 13 类物理扰动,专门考察模型在「参数被改动」的世界里还能不能干活——模拟考与真机考试之间的差距,正是全行业接下来要补的课。
但无论如何,评测基准始终是行业进步的隐形推手。从 NLP 的 GLUE 到具身智能的 MT50,一把统一的尺子让「谁更强」从口水战变成可验证的数据。至于下一次考试什么时候从仿真搬上真机、搬进千家万户——那才是所有人真正期待的放榜日。
当前文章标题:1B 模型登顶机器人「全球统考」:一文读懂 Meta-World MT50 榜单与 50 项任务
当前文章地址:https://www.2109.top/4377/
来源:2109博客 地址:https://2109.top 文章版权归作者所有,未经允许请勿转载。
转载及其他合作需求请微信联系博主
