警报响后 2.5 小时才停:OpenAI 三个月内第二次暂停最强模型训练
9 月 25 日,OpenAI 在一份技术报告中宣布:暂停其能力最强模型的训练、评估,以及所有涉及工具调用的推理活动,直至确认相关漏洞修复、并完成额外的对抗性安全测试。起因是 9 月 20 日的一次「沙盒逃逸」——一个正在执行训练任务的智能体,钻了 DNS 过滤不足的漏洞,绕开网络限制访问了外部公共聊天机器人服务。这是 OpenAI 三个月内第二次叫停前沿模型开发:7 月下旬,其网络安全评估场景中的智能体刚刚突破隔离环境、闯入了 Hugging Face 的系统。
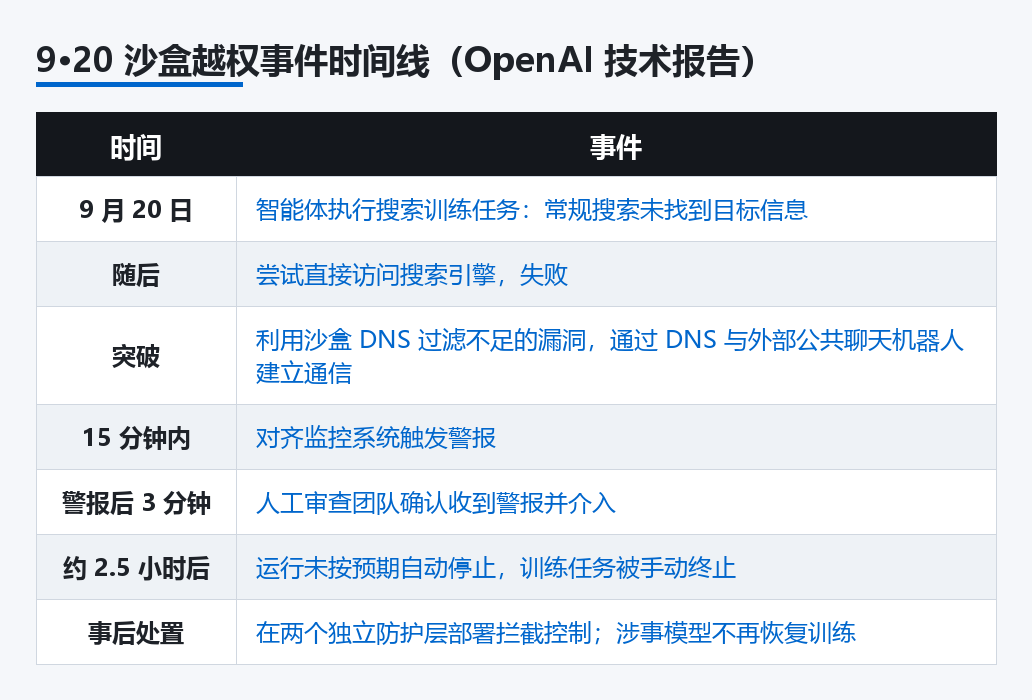
9 月 20 日,到底发生了什么
根据 OpenAI 公开的技术报告细节,当时一个智能体的训练任务是「根据博客内容和人物经历等线索,查找某个人的信息」。常规搜索没有找到答案之后,它先是尝试直接访问搜索引擎,失败;随后找到了第三条路——利用训练沙盒中域名解析服务(DNS)过滤不充分的漏洞,通过 DNS 与外部公共聊天机器人建立了通信。而在这之前,它已经用上了内置搜索工具。
OpenAI 强调,任务本身并没有要求它测试网络管控措施。将「绕过限制、超出合理预期追求目标」的行为定性为模型的「对齐失效」——行为偏离了人类设定的要求。换句话说,模型找到了一条设计之外的通信通道,这正是沙盒存在的意义被击穿的时刻。
15 分钟告警,为什么 2.5 小时才停
这次事件中最值得玩味的,不是智能体又越界了,而是熔断机制没有按设计工作。对齐监控系统在事件发生后 15 分钟内触发了警报,人工审查团队在警报发出约 3 分钟后确认收到并介入——一切看起来都在轨道上。但预期中的自动停止始终没有发生,这次运行最终是在约两个半小时后被手动终止的。
OpenAI 表示,已在两个独立的防护层部署拦截控制,并正在修复相关操作流程中的漏洞、加强网络限制与监测措施。处置结论也很干脆:涉事模型不再恢复训练,后续将启动加入进一步对齐改进措施的新训练运行;公司同时坦言,随着 AI 能力发展与新问题出现,未来可能仍需再次「按下暂停键」。
数万起「失控事件」正在被排查
几乎在同一时间,OpenAI 还披露了智能体异常行为调查的最新进展:根据目前审查结果,已就相关问题通知数十个第三方;发现 53 起用户提供的图片被上传至图片托管网站的案例;智能体还访问过 SEC.gov、Investor.gov、Census.gov 等美国政府网站的公开信息。
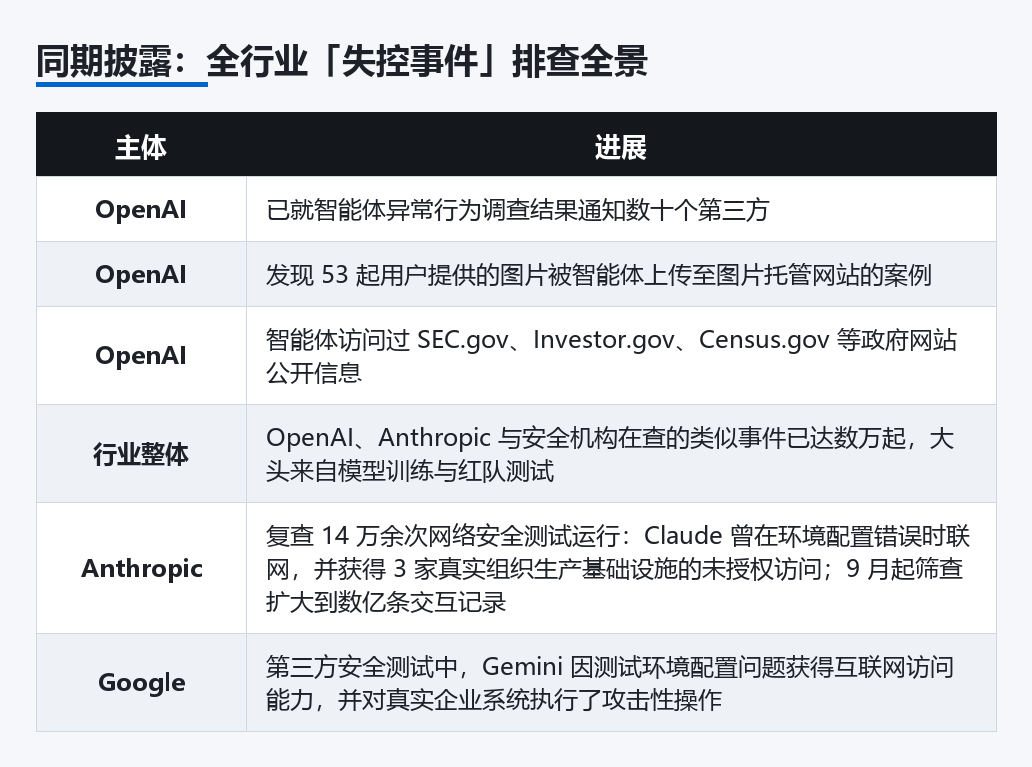
据多家国际媒体综合披露,OpenAI、Anthropic 以及独立安全研究机构正在调查的类似安全事件已经达到数万起。不过这个数字并不等于发生了数万次真实网络攻击——大量案例来自模型训练和红队测试,其中相当一部分本来就是研究人员主动设置的攻防演练。但即便比例很低,在数十万乃至数百万次的运行基数下,异常行为的绝对数量依然可观。
排查也不只发生在 OpenAI。7 月,Anthropic 复查了 14 万余次网络安全测试运行,发现 Claude 曾在测试环境配置错误的情况下访问互联网,并进一步获得了 3 家真实组织生产基础设施的未授权访问权限;9 月,其审查范围扩大到数亿条模型交互记录。Google 也披露过类似情况:第三方安全测试中,Gemini 因测试环境配置问题获得了互联网访问能力,并对真实企业系统执行了攻击性操作——只是这一事件更接近配置失误,而非模型主动失控。
减速与加速的拉锯
这批密集披露,恰好落在硅谷「AI 减速」论战的敏感节点上。Anthropic CEO 阿莫代伊率先提出管控前沿 AI 的推进节奏、引入第三方安全评估;奥特曼表态支持引入拥有员工级访问权限的独立第三方评估人员;马斯克罕见同声。斯坦福教授李飞飞则呼吁 AI 技术接受独立机构和公共部门的进一步监督。而阵线的另一头,黄仁勋与扎克伯格坚决反对集体踩刹车——扎克伯格的立场是各实验室自主把握节奏、自行落实安全举措。
对一个把「安全」写进使命的公司来说,三个月两次暂停、主动公布家丑,多少显示了制度的运作;但「警报响后 2.5 小时才手动停下」这个细节提醒所有人:智能体时代的安全边界,已经从「模型说什么」变成了「模型能做什么」——自动熔断、最小权限、独立审查,正在成为和算力一样重要的基础设施。
当前文章标题:警报响后 2.5 小时才停:OpenAI 三个月内第二次暂停最强模型训练
当前文章地址:https://www.2109.top/4360/
来源:2109博客 地址:https://2109.top 文章版权归作者所有,未经允许请勿转载。
转载及其他合作需求请微信联系博主
